В статье
сайт/данные/просмотры.json, панель/данные/report.json. Ключевых слов нет: материал писался под жанр площадки, а не под поисковый запрос. Ссылки на портал: нет - правила Хабра против ссылок на свой проект, свой сайт только в профиле. Служебная шапка, в публикацию не идёт. Третий материал для Habr. Первые два были про сбор чужих данных: регулярки и ошибки парсера. Этот намеренно про другое - про свой сервер и свои логи, чтобы три статьи подряд не читались как одна. Чего нет намеренно: названия портала, адреса сайта и любых ссылок. Правила площадки запрещают самопиар прямо, а ссылочного веса Habr всё равно не передаёт (rel nofollow noopener). Идём за читателем. Все числа свои и датированы 30.09.2026. Код в тексте - настоящие куски рабочего скрипта, а не переписанный для примера.Счётчик просмотров замолчал после переезда, и я стал считать по логам nginx
У меня небольшой контентный сайт: несколько десятков статей, свой счётчик просмотров, дашборд, куда это всё стекается. Счётчик был встроен в приложение и считал в тот момент, когда страницу отдавала моя же служба. Пока сайт жил на своём движке, это работало.
Одиннадцатого сентября сайт переехал на WordPress. Страницы стала отдавать другая программа, моя служба перестала участвовать в выдаче - и счётчик замолчал. Не сломался с ошибкой, не написал ничего в лог, а просто перестал получать события.
Хуже другое. Дашборд не знал, что данные больше не приходят, и продолжал показывать последнее число как текущее. Четыре дня подряд на видном месте стояло одно и то же значение, и выглядело оно как честная статистика. Я заметил это только тогда, когда цифра не изменилась в день выхода новой статьи - а такого не бывает.
Из этого получился первый вывод, ещё до всякого кода: счётчик обязан уметь сказать, что он ничего не посчитал. Молчание и ноль - разные вещи, и показывать их одинаково нельзя.
Почему логи, а не счётчик внутри движка
Вариантов было три.
Поставить плагин в WordPress. Отпало: плагин считает там же, где живёт движок, и следующий переезд повторит историю. Мне нужен был счёт, который не зависит от того, чем именно отдаётся страница.
Довериться внешней аналитике - она у меня стоит и работает. Тоже не подошло, но по другой причине, и к ней я вернусь в конце: внешний счётчик считает по JavaScript и видит не всех.
Считать по access.log. У nginx уже есть запись о каждом запросе, она лежит
на диске, её никто не отключал при переезде. Плюс, которого нет ни у плагина,
ни у внешней аналитики: данные есть задним числом. Те четыре дня, что
дашборд врал, лежали в архивах логов, и их удалось восстановить.
Дальше про то, как это считается и на чём я успел ошибиться.
Разбор строки
Формат строки у nginx по умолчанию такой, что регулярка получается длинной, зато читаемой:
СТРОКА = re.compile(
    r'^(?P<адрес>\S+) \S+ \S+ \[(?P<время>[^\]]+)\] '
    r'"GET (?P<путь>/statya/[^ ?"]*)[^"]*" (?P<код>\d{3}) \d+ '
    r'"[^"]*" "(?P<агент>[^"]*)"')
Три вещи тут стоят отдельного слова.
/statya/[^ ?"]* вместо просто [^ "]* - потому что в запросе бывает строка
параметров, и ?utm_source=... не должен попадать в путь. Иначе одна и та же
статья разъезжается на десяток разных «страниц».
GET жёстко: POST к странице статьи - это не просмотр.
Именованные группы, а не индексы. Регулярка переживёт ещё пару правок,
а м.group(4) через месяц не читается вовсе.
Что отсеивается и почему
Сначала простое.
if м["код"] != "200" or БОТЫ.search(м["агент"] or ""):
    return None
if м["адрес"] in СВОИ_АДРЕСА:
    return None
Не 200. Переадресации и 404 в счёт не идут. Отдельно стоит сказать
про 304: если считать ответы Not Modified, возвраты читателя по кнопке
«назад» превращаются в просмотры.
Боты. Список тот же, что был в прежнем счётчике, и он длинный:
БОТЫ = re.compile(
    r"bot\b|bot/|spider|crawl|slurp|yandexbot|yandexmetrika|googlebot|bingbot|"
    r"baiduspider|ahrefs|semrush|mj12|dotbot|petalbot|dataforseo|serpstat|"
    r"headlesschrome|python-requests|curl/|wget|go-http|java/|okhttp|scrapy",
    re.I)
headlesschrome в этом списке - мой собственный след: я хожу на свой сайт
браузером Playwright, когда проверяю вёрстку. Первые прогоны считали эти
заходы просмотрами, и самой популярной статьёй оказывалась та, которую
я в тот день правил.
bot\b|bot/ вместо просто bot - иначе под правило попадает любой агент,
где эти три буквы встретились внутри слова.
Свои адреса. Локальная петля и внешний адрес самого сервера. Сюда попадают сборки, проверки ссылок и вызовы из скриптов.
Две ошибки в пути, обе нашлись на живых данных
Первая версия брала слаг как последний кусок пути:
слаг = путь.split("/")[-1]
Двадцать третьего сентября в списке самых читаемых статей появилась строка
frantlas_admin. Это служебный адрес админки, и в счёт он попал потому,
что тоже начинался с /statya/.
Я добавил проверку «путь начинается с statya» и посчитал, что закрыл дыру.
На следующий день frantlas_admin вернулся. Оказалось, WordPress отдаёт
страницу автора по адресу вида /statya/author/<логин>/, и она проходит
проверку на префикс идеально.
Рабочая версия считает куски:
куски = путь.split("/")
if len(куски) != 2 or куски[0] != "statya":
    return None
Ровно два куска, первый - statya. Всё, что глубже или мельче, не статья.
Вывод, который я себе записал: проверять надо форму пути целиком, а не его начало. Префикс - это фильтр, который пропускает всё, о чём вы не подумали.
Повторы: самая большая правка в числах
Читатель открывает статью, дочитывает до середины, обновляет страницу, возвращается по кнопке «назад». В логах это четыре строки.
Я отсеиваю повторный заход того же читателя в ту же статью в течение получаса:
СРОК_ПОВТОРА = 30 * 60
...
ключ = (слаг, читатель)
было = последние.get(ключ)
if было and (когда - было).total_seconds() < СРОК_ПОВТОРА:
    отсеяно += 1
    continue
последние[ключ] = когда
Насколько это важно, видно по последнему прогону: из 241 подходящей строки повторами оказались 168. Это не погрешность, это больше половины. Счётчик без дедупликации показал бы почти втрое большее число, и оно выглядело бы совершенно правдоподобно.
Полчаса - величина, которую я взял у сессионной аналитики и не проверял на своих данных. Честно считаю её допущением, а не измерением.
Отдельно про счётчик отсеяно. Он не нужен для результата, но он выводится
в конце каждого прогона рядом с числом разобранных строк. Пока эти два числа
стоят рядом, я вижу, что фильтр жив. В тот день, когда отсев обнулится,
я узнаю об этом сразу, а не через месяц по кривому графику.
Кто такой «тот же читатель», если адреса нельзя хранить
Дедупликация требует различать читателей, а адрес - это персональные данные, и держать его на диске мне не хочется.
читатель = hashlib.sha256(
    (м["адрес"] + (м["агент"] or "")).encode()).hexdigest()[:16]
Хэш от адреса вместе с агентом, обрезанный до шестнадцати символов. Он живёт только в памяти во время прогона, на диск попадают исключительно счётчики по дням.
Честно про границы такого решения. Хэш от адреса - псевдонимизация, а не анонимизация: пространство адресов маленькое, и при желании его перебирают. Мне этого достаточно, потому что хэш никуда не сохраняется; если бы сохранялся, к нему надо было бы относиться как к самому адресу.
Склейка адреса с агентом даёт побочный эффект: один человек, открывший статью с телефона и с ноутбука, посчитается дважды. Меня это устраивает больше, чем обратная ошибка, когда за одного принимают двух читателей из-за общего адреса провайдера.
Задним числом
Ради этого всё и затевалось. Ротация nginx оставляет access.log.1 и дальше
сжатые access.log.2.gz и так далее.
имена = ["access.log"]
if все_архивы:
    имена += ["access.log.1"] + [f"access.log.{н}.gz" for н in range(2, 15)]
Архивы читаются только по ключу --всё. Обычный прогон разбирает свежий лог
и стоит доли секунды, полный проходит по двум неделям истории.
Логи принадлежат root:adm, поэтому чтение идёт через sudo -n cat:
готово = subprocess.run(["sudo", "-n", "cat", str(путь)], capture_output=True)
if готово.returncode != 0:
    continue
-n важен: без него на сервере без прав команда встанет и будет ждать ввода
пароля, которого никто не введёт, - а это крон. И continue вместо падения:
архивов за все четырнадцать номеров обычно нет, отсутствие файла тут
нормальное состояние, а не ошибка.
Распаковка вынесена отдельно и тоже не роняет прогон:
if имя.endswith(".gz"):
    try:
        данные = gzip.decompress(данные)
    except Exception:
        continue
Битый архив бывает, когда ротация случилась прямо во время чтения.
Перезапись, а не сложение
Скрипт можно запустить дважды за день, и это не должно удваивать числа.
запись["по_дням"].update(по_дням)
запись["всего"] = sum(запись["по_дням"].values())
День - ключ, новое значение заменяет прежнее, итог пересчитывается из суммы, а не накапливается инкрементом. Отсюда же свойство, которое мне нравится больше всего: счёт идемпотентен. Прогон по архивам поверх уже посчитанных дней даёт тот же результат, а не второй слой.
Логи и внешняя аналитика показывают разные числа, и это нормально
Сейчас у меня рядом стоят два числа за один и тот же период (30 сентября 2026 года, числа живые и назавтра будут другими):
- по логам - 701 просмотр по 27 статьям;
- во внешней аналитике - 652 просмотра и 273 визита.
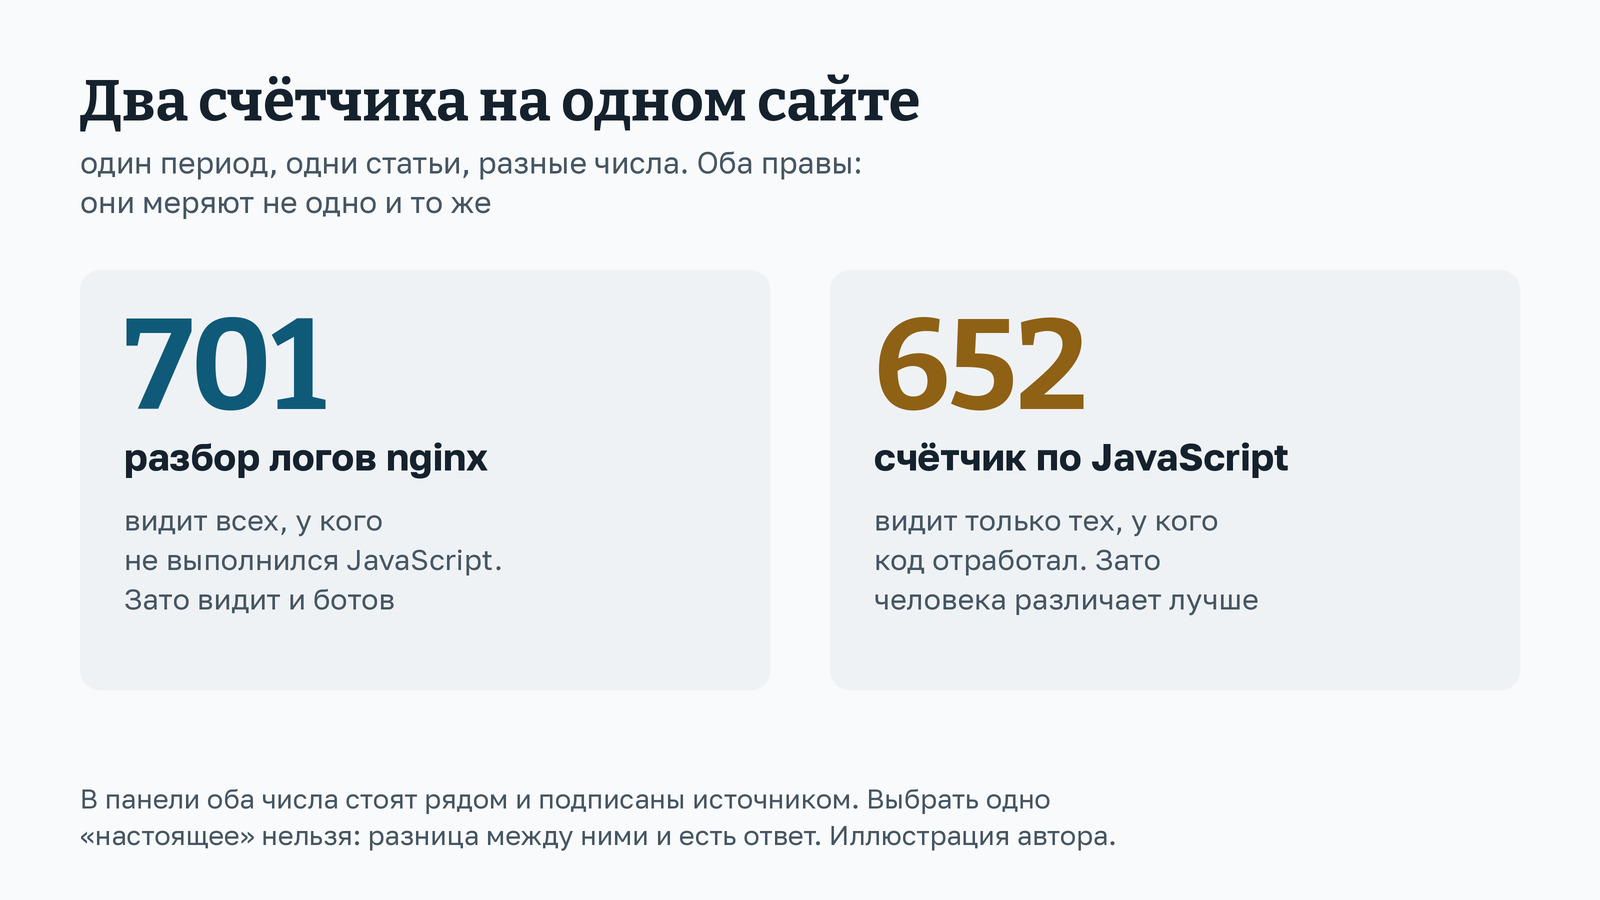
Первое желание - найти, кто из них врёт. Правильный ответ - никто, они меряют разное.
Логи видят каждый запрос к серверу, включая тех читателей, у кого не выполнился JavaScript: отключён, не догрузился, вырезан блокировщиком. Зато логи видят и ботов, которых я отсеиваю списком, а список всегда неполон.
Внешний счётчик видит только тех, у кого код отработал, зато он различает человека надёжнее и умеет отличать визит от просмотра.
Поэтому в дашборде они стоят рядом, обе подписаны источником, и ни одна не объявлена главной. Соблазн показать одно «настоящее» число большой, но любое из них будет неправдой ровно настолько, насколько отличается от другого.
Что стоит забрать
Молчащий счётчик опаснее сломанного: сломанный видно сразу, молчащий показывает вчерашнее число как сегодняшнее.
Проверять форму пути целиком, а не префикс. Служебные адреса движка почти всегда лежат в том же дереве, что и статьи.
Считать повторы отдельно и выводить это число рядом с результатом. У меня повторами оказалась больше половины строк, и без отсева счётчик врал бы втрое, оставаясь правдоподобным.
Хэшировать читателя, а не хранить адрес, и вслух называть, что это псевдонимизация, а не анонимность.
Делать прогон идемпотентным, чтобы повторный запуск был безопасной операцией, а не источником удвоений.
И держать два разных счёта рядом, вместо того чтобы выбирать между ними один. Расхождение в полсотни просмотров - не ошибка измерения, а разница в том, что именно каждый из них способен увидеть.